



英伟达发布超长上下文推理芯片Rubin CPX 算力效率拉爆当前旗舰
全球人工智能算力芯片龙头英伟达周二宣布,推出专为长上下文工作负载设计的专用GPU Rubin CPX,用于翻倍提升当前AI推理运算的工作效率,特别是编程、视频生成等需要超长上下文窗口的应用。
英伟达CEO黄仁勋表示,CPX是首款专为需要一次性处理大量知识(数百万级别tokens),并进行人工智能推理的模型而构建的芯片。
需要说明的是,Rubin就是英伟达将在明年发售的下一代顶级算力芯片,所以基于Rubin的CPX预计也要到2026年底出货。下一代英伟达旗舰AI服务器的全称叫做NVIDIA Vera Rubin NVL144 CPX——集成36个Vera CPU、144块Rubin GPU和144块Rubin CPX GPU。
英伟达透露,搭载Rubin CPX的Rubin机架在处理大上下文窗口时的性能,能比当前旗舰机架GB300 NVL72高出最多6.5倍。
据悉,下一代旗舰机架将提供8exaFLOPs的NVFP4算力,比GB300 NVL72高出7.5倍。同时单个机架就能提供100TB的高速内存和1.7PB/s的内存带宽。
言归正传,英伟达之所以要在Rubin GPU边上再配一块Rubin CPX GPU,自然是为了显著提升数据中心的算力效率——用户购买英伟达的芯片将能赚到更多的钱。英伟达表示,部署价值1亿美元的新芯片,将能为客户带来50亿美元的收入。
为何需要不同的GPU?
作为行业首创之举,英伟达的新品在硬件层面上分拆了人工智能推理的计算负载。
英伟达介绍称,推理过程包括两个截然不同的阶段:上下文阶段与生成阶段,两者对基础设施的要求本质上完全不同。
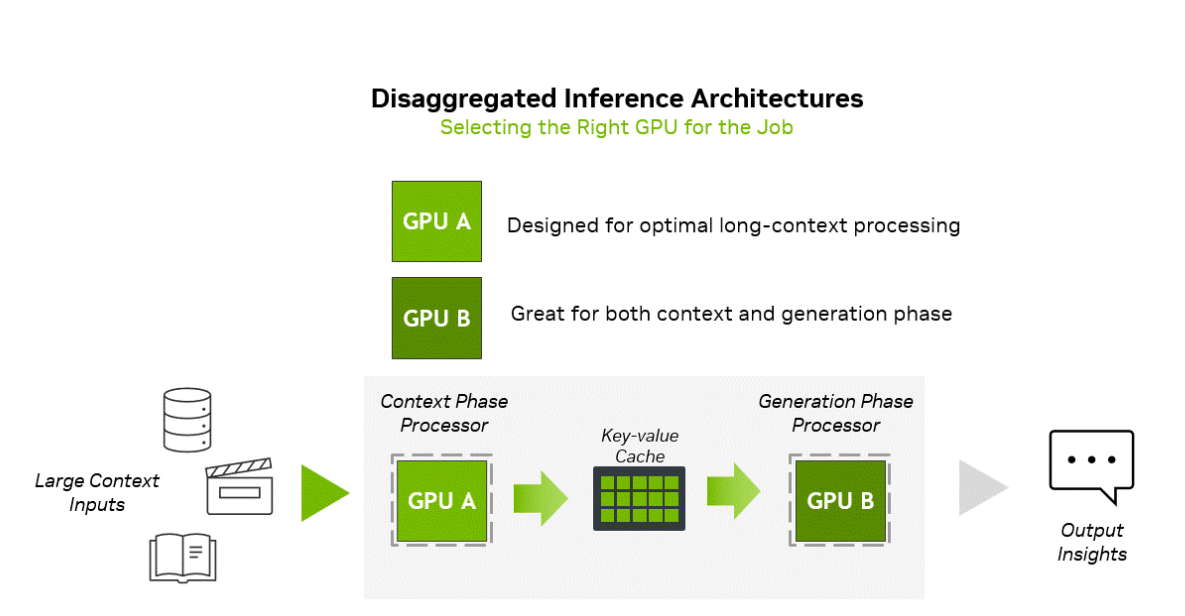
上下文阶段属于计算受限(compute-bound),需要高吞吐量的处理能力来摄取并分析大量输入数据,从而生成首个输出token。相反,生成阶段则属于内存带宽受限(memory bandwidth-bound),依赖高速的内存传输和高带宽互联(如 NVLink),以维持逐个token的输出性能。
当前顶级的GPU都是为了内存和网络限制的生成阶段设计,配备昂贵的HBM内存,然而在解码阶段并不需要这些内存。因此,通过分离式处理这两个阶段,并针对性地优化计算与内存资源,将显著提升算力的利用率。
据悉,Rubin CPX专门针对“数百万tokens”级别的长上下文性能进行优化,具备30petaFLOPs的NVFP4算力、128GB GDDR7内存。
英伟达估计,大约有20%的AI应用会“坐等”首个token出现。例如解码10万行代码可能需要5-10分钟。而多帧、多秒的视频,预处理和逐帧嵌入会迅速增加延迟,这也是为什么当前的视频大模型通常仅用于制作短片。
英伟达计划以两种形式提供Rubin CPX,一种是与Vera Rubin装在同一个托盘上。对于已经下单NVL144的用户,英伟达也会单独出售一整个机架的CPX芯片,数量正好匹配Rubin机架。
本资讯中除公开信息外的其他数据均是基于公开信息(包括但不仅限于行业新闻、研讨会、展览会、企业财报、券商报告、国家统计局数据、海关进出口数据、各大协会和机构公布的各类数据等等),并依托废废网/道奇财经内部数据库模型,由研究小组进行综合分析和合理推断得出,仅供参考,不构成决策建议,客户决策应自主判断,与废废网/道奇财经无关。
废废网/道奇财经对本声明条款拥有最终解释权,并保留根据实际情况对声明内容进行调整和修改的权利。





